Was verspricht die KI? Viele würden sagen, es sei die Effizienz: Lücken zu schließen, die durch menschliches Handeln entstehen und sich wiederholende Arbeiten zu automatisieren. Doch damit bleibt vieles ungesagt, insbesondere was die Sicherheit betrifft.
Wenn Entwickler beispielsweise „Vibe-Code“ erstellen und Nutzer Modelle, Agenten und deren Fähigkeiten aus öffentlichen Repositories herunterladen, wird es schwieriger zu beurteilen, ob jeder Teil des Prozesses vertrauenswürdig ist. In der Cybersicherheit spricht man hier von einer digitalen Lieferkette: KI-Modelle, Copiloten von Drittanbietern, Agenten-Frameworks und KI-gestützte Arbeitsabläufe schaffen neue Abhängigkeiten.
Und wie die jüngsten Vorfälle in der npm-Lieferkette (Node Package Manager) gezeigt haben, kann Vertrauen die Risiken ebenso schnell erhöhen, wie es die Produktivität steigert. Im KI-Bereich könnte gerade das Streben nach schnellen Erfolgen ohne gründliche Prüfung genau der Punkt sein, an dem das nächste Schwachglied auftritt.
Kernaussagen dieses Artikels:
- Die Einführung von KI erweitert die Unternehmenslieferkette über Softwarepakete hinaus und fügt der Vertrauensgleichung Modelle, Agenten, Skills, Plug-ins und externe Eingaben hinzu.
- Der traditionelle Missbrauch von Abhängigkeiten, wie er bei npm-Angriffen zu beobachten ist, liefert eine nützliche Warnung für den KI-Bereich: Vertrauenswürdige Komponenten können zu Angriffspfaden werden, wenn die Überprüfung nachlässt.
- Agentische KI verändert die Risikobewertung, da diese Tools nicht nur Text generieren, sondern auch im Namen der Nutzer surfen, Daten abrufen, Dienste aufrufen und handeln können.
- Die Lösung besteht nicht darin, KI gänzlich zu vermeiden, sondern zu regeln, auf was Agenten zugreifen dürfen, gefährliche Abhängigkeiten vor der Nutzung zu blockieren und das Verhalten dort zu überwachen, wo die Arbeit stattfindet.
- Außerdem: Nein, der Einsatz von KI vor Ort beseitigt das Problem nicht. Prompt-Injektion, manipulierte Skills, bösartige Pakete und mangelnde Beobachtbarkeit können vertrauenswürdige Automatisierung dennoch gegen das Unternehmen wenden.
Die digitale Lieferkette
Es ist kein Geheimnis, warum die digitale Lieferkette Unternehmen im Laufe der Jahre viele Probleme bereitet hat. Wobei schwerwiegende Vorfälle auf die Nutzung von Produkten oder Tools von Drittanbietern wie SolarWinds Orion zurückzuführen waren. Doch während Vorfälle in der Lieferkette in großem Maßstab enorme Auswirkungen haben können, können auch einzelne Eigenmächtigkeiten im Umgang mit einer KI jedem Unternehmen ernsthaften Schaden zufügen.
Nun geht es nicht nur darum, was diese Ketten enthalten oder warum Angreifer sie ins Visier nehmen. Es geht vielmehr darum – oder sollte zumindest darum gehen –, was sie so mächtig macht. Man denke an Softwarebibliotheken wie lodash, requests oder react. Sie existieren, weil von Entwicklern nicht erwartet werden kann, jede Komponente selbst zu programmieren. Selbst die Entwicklung einer einfachen Anwendung kann Wochen oder Monate in Anspruch nehmen, während produktionsreife Unternehmenssoftware oft noch länger dauert. Softwarebibliotheken lösen dieses Problem, indem sie es Teams ermöglichen, bewährten Code wiederzuverwenden, anstatt bei Null anzufangen. Doch genau diese Bequemlichkeit birgt auch Abhängigkeitsrisiken.
Ein weit verbreitetes Paket wie „axios“, einer der beliebtesten JavaScript-HTTP-Clients auf npm, kann in unzähligen Anwendungen enthalten sein. Dies bedeutet, dass sich das Vertrauen in eine Komponente unbemerkt auf einen großen Teil des Software-Ökosystems ausweiten kann. Der Missbrauch dieses Vertrauens ist somit die entscheidende Komponente.
Für alle, die es noch nicht wissen: Was ist npm?
npm ist das wichtigste Paket-Ökosystem für JavaScript (eine Programmiersprache), um Open-Source-Code herunterzuladen und wiederzuverwenden, anstatt jede Komponente von Grund auf neu zu erstellen.
Das Jahr der npm-Lieferkettenangriffe
Das npm-Ökosystem hat wiederholt gezeigt, wie fragil das Vertrauen in Abhängigkeiten werden kann. Seit 2025 nutzten Kampagnen wie Shai-Hulud und Mini Shai-Hulud wurmartiges Verhalten, um sich über vertrauenswürdige Paketbeziehungen zu verbreiten. Dabei stahlen sie Anmeldedaten von Entwicklern und Cloud-Diensten, um manipulierte Paketversionen zu veröffentlichen. Doch der Diebstahl von Anmeldedaten ist nur ein Weg. In anderen Fällen nutzen Angreifer möglicherweise die Arbeitsabläufe von Betreuern, Verwirrung bei den Abhängigkeiten, bösartige Updates oder kompromittierte Build-Prozesse aus.
So oder so geht die Gefahr nicht nur von bösartigem Code aus, sondern auch von vertrauenswürdigen Installations- und Build-Systemen, die die Verbreitung des Codes bzw. der Aktivitäten begünstigen können. Noch schlimmer ist, dass sich dieselben Vertrauensabhängigkeiten nun auch aus den KI-Stacks einschleichen, die Unternehmen leichtfertig einführen.
Der Feind im eigenen Haus: KI, Vertrauen und begehrte Kompetenzen
Auf der Suche nach höherer Produktivität (deren Ergebnisse fragwürdig sind) und überzeugt durch KI-Unternehmen mit riesigen Marketingbudgets (und einigen legitimen Ergebnissen¹) führen Organisationen rasch eine ganze Reihe von KI-Modellen ein, unabhängig davon, ob ein echter Bedarf dafür besteht oder nicht. Unbestreitbar ist jedoch, dass ihr Einsatz in manchen Fällen durchaus willkommen ist.
Aber das ist alles nebensächlich. Was zählt, sind all die Sicherheitslücken, die die Einführung von KI mit sich bringt. Lassen Sie uns dies anhand eines Beispiels erläutern.
Nehmen wir an, eine Marketingagentur führt einen KI-Bot mit agentenartigen Fähigkeiten ein, um einige administrative Aufgaben (zum Beispiel das Berichtswesen) zu automatisieren. Dabei bleibt den Marketingmitarbeitern auch Spielraum erhalten, um die generativen Eigenschaften des Bots für kreative Zwecke zu nutzen. Dieses Modell ist natürlich mit dem Internet verbunden, da die Möglichkeit, online nach Inspiration zu suchen, sinnvoll ist.
Diese Konfiguration schafft jedoch eine Vertrauenskette. Die Agentur vertraut nicht mehr nur dem KI-Anbieter, sondern auch dem Surfverhalten des Modells, den von ihm abgerufenen Quellen, den verwendeten Plug-ins oder Konnektoren, den Eingabeaufforderungen, die es erhält, und den Berechtigungen, über die es innerhalb der Unternehmensumgebung verfügt.
Wenn der Bot Zugriff auf Kampagnenberichte, gemeinsam genutzte Laufwerke, Kundenbriefings, Analyse-Dashboards oder E-Mail-Exporte hat, gleicht seine Rolle als „administrativer Helfer“ schnell eher der eines Nachwuchsmitarbeiters mit weitreichenden Zugriffsrechten und sehr geringem Misstrauen.
Stellen Sie sich nun vor, dass der Bot bei einer seiner internetgestützten Rechercheaufgaben auf eine manipulierte Webseite (oder Dokumente) stößt, die als Marketingleitfaden getarnt ist. Für einen menschlichen Leser mag die Seite wie ein allgemeiner Ratschlag zur Verbesserung der Anzeigenleistung aussehen. Für das KI-System hingegen könnten in der Seite eingebettete versteckte Anweisungen versuchen, seine ursprüngliche Aufgabe zu überschreiben und stattdessen interne Kampagnendaten abzurufen, Kundeninformationen zusammenzufassen oder Ergebnisse an einen vom Angreifer kontrollierten Endpunkt zu senden, sofern ein verbundenes Tool dies zulässt.
Dies ist die KI-Version des Missbrauchs von Abhängigkeiten. Die bösartige Komponente ist kein heruntergeladenes Paket, sondern eine nicht vertrauenswürdige externe Eingabe, die das System bereitwillig als Teil seines Arbeitsablaufs behandelt.
Und da der Bot im Namen echter Nutzer handelt, kann der Schaden subtil sein. Niemand hat im herkömmlichen Sinne auf Malware geklickt oder diese heruntergeladen. Kein Entwickler hat absichtlich eine manipulierte Bibliothek installiert. Das Unternehmen hat lediglich ein hilfreiches Tool mit nützlichen Daten verbunden, ihm Internetzugang gewährt und davon ausgegangen, dass sich dessen Ausgaben auf die jeweilige Aufgabe beschränken. Sobald KI-Systeme jedoch selbstständig Daten abrufen, interpretieren und darauf reagieren können, wird jede externe Quelle, die sie aufnehmen, Teil der betrieblichen Lieferkette – wie wir beispielsweise bei einigen jüngsten Vorfällen gesehen haben, bei denen KI-Systeme Testgrenzen überschritten haben.
„Wenn KI-gestützte Plattformen in Eile entwickelt werden, sind grundlegende Maßnahmen zur Cybersicherheit und zum Datenschutz oft das Erste, was auf der Strecke bleibt“, kommentierte Jake Moore, Spezialist für Cybersicherheitsbewusstsein bei ESET. „Das eigentliche Risiko sind nicht die KI-Agenten selbst, sondern die dahinterliegende Infrastruktur, wo ungeschützte Datenbanken und schlampige Authentifizierung ein einfaches Versehen in eine schwerwiegende Sicherheitslücke verwandeln können.“
Skills, für die man sterben würde
Ein besonders anschauliches Beispiel für diese blinden Flecken in der Praxis sind die Tausenden bösartiger KI-Skills, die ESET Research entdeckt hat. ESET hat über 900.000 KI-Skills aus beliebten Repositories analysiert und festgestellt, dass 25.000 davon verdächtig und über 3.000 sogar eindeutig bösartig waren.
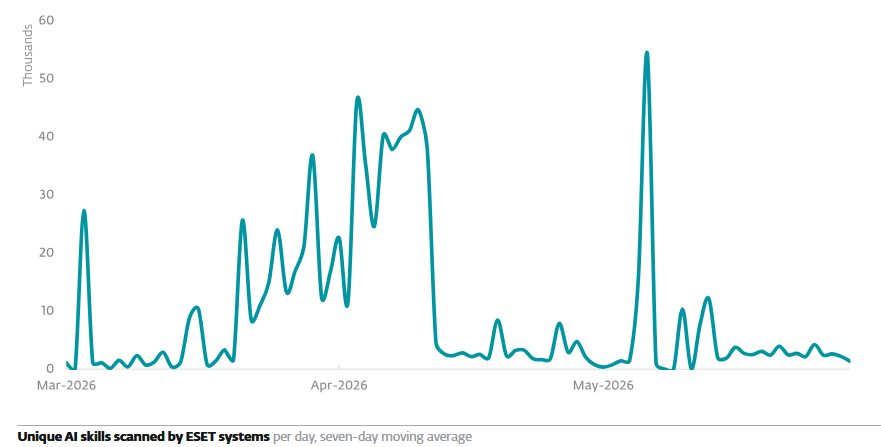
Diese Skills sind – für Uneingeweihte – im Wesentlichen kleine Aufgabenanleitungen für KI-Agenten. Sie sagen dem Agenten, was er tun soll, welche Tools oder Dienste er aufrufen soll und auf welche Daten er dabei möglicherweise zugreifen muss. In einer harmlosen Umgebung klingt das durchaus nützlich: eine Möglichkeit, agentenbasierte KI leistungsfähiger, konsistenter und einfacher in geschäftliche Arbeitsabläufe zu integrieren.
Sind Sie besorgt wegen eines KI-Skills, den Sie heruntergeladen haben? Probieren Sie den ESET Skills Checker aus.
Das Problem ist, dass Skills dadurch auch zu einem idealen Ort werden, um böswillige Absichten zu verbergen. Ein Skill kann missbraucht oder von vornherein so programmiert werden, dass er einen Agenten unbemerkt von der eigentlichen Anfrage des Nutzers ablenkt. Das kann bedeuten, Daten zu exfiltrieren, Malware herunterzuladen und auszuführen, Anweisungen des Nutzers zu überschreiben, das Verhalten des Agenten im Laufe der Zeit subtil zu verändern oder sogar den Skill selbst so zu modifizieren, dass die Kompromittierung schwerer zu erkennen ist.
Credit Claw
Ein hervorragendes Beispiel für eine solche Skill aus dem Scan von ESET ist „Credit Claw“. Diese Skill ermöglicht es dem Agenten, Einkäufe über Plattformen wie Amazon und Shopify zu tätigen und sich in Software-as-a-Service-Umgebungen (SaaS) zu integrieren. Das Risiko liegt in seinem Zugriff auf Zahlungsmethoden und damit im direkten Zugriff auf das Geld des Nutzers. Ein schädliches Update oder eine schädliche Abhängigkeit könnte das Verhalten dieses Agenten unbemerkt verändern und die gekauften Waren oder Dienstleistungen an den Angreifer umleiten.
Das ist das Problem bei agentischer KI. Während Chatbots die endgültige Entscheidung (die wiederum durch Datenvergiftung beeinflusst werden kann) dem Nutzer überlassen, sind agentische KIs eigenständige Akteure. Das macht die Überwachung komplizierter – insbesondere wenn ein Agent in der Lage ist, sein Verhalten schrittweise von harmlos zu bösartig zu verändern.
Es geht wieder einmal um Wahrnehmung vs. Realität
Der ESET SMB Cyber Readiness Index 2026 legt nahe, dass sich die Sicherheitslandschaft nicht verändert hat. Vielmehr hat sich lediglich der Wind gedreht und die Wahrnehmung von KI unverhältnismäßig aufgeblasen. Weitere Untersuchungen von ESET² bestätigen dies mit dem Vorbehalt, dass diese Wahrnehmungen auf einem weitreichenden Missverständnis der Cybersicherheit seitens der befragten Nutzer in den untersuchten Unternehmen beruhen.
Wenn Unternehmen also wissen, dass KI risikobehaftet ist, warum setzen sie sie dann weiterhin ein? Dem Index zufolge erkennen 70 % an, dass KI zusätzliche Risiken mit sich bringt, doch nur 60 % verfügen über eine Richtlinie zur KI-Sicherheit und -Governance.
Tatsächlich überschätzen Unternehmen möglicherweise die Bedrohung durch KI-gestützte Malware, während sie gleichzeitig die Risiken unterschätzen, die durch den Einsatz von KI-Systemen entstehen, die bereits über legitimen Zugriff auf die Unternehmensinfrastruktur verfügen. Da KI-Agenten zunehmend in der Lage sind, im Namen der Nutzer Maßnahmen zu ergreifen, verlagert sich die Herausforderung vom Stoppen bösartigen Codes hin zur Überwachung „vertrauenswürdiger“ Automatisierungsprozesse. Ein kompromittierter Endpunkt lässt sich isolieren. Eine bösartige KI-Funktion, die innerhalb genehmigter Arbeitsabläufe agiert, ist hingegen viel schwerer zu erkennen.
Und dabei haben wir noch nicht einmal „Shadow-KI“ erwähnt, eine weitaus mächtigere und schwerer fassbare Bedrohung.
Bequemlichkeit mindert die Wachsamkeit
So wie npm-Angriffe Entwicklern beigebracht haben, zu hinterfragen, was sie in ihre Anwendungen importieren, sollte agentische KI Unternehmen lehren, was sie in ihre Entscheidungen einfließen lassen. Die Installation eines Skills könnte sich bald so routinemäßig anfühlen wie die Installation einer Browser-Erweiterung, eines SaaS-Plug-ins oder eines Open-Source-Pakets. Und genau darin liegt das Problem.
Das KI-Skill-Ökosystem weist beispielsweise viele der Lieferkettenrisiken auf, die bei Open-Source-Software, Browser-Erweiterungen, npm-Paketen und Entwickler-Tools zu beobachten sind.
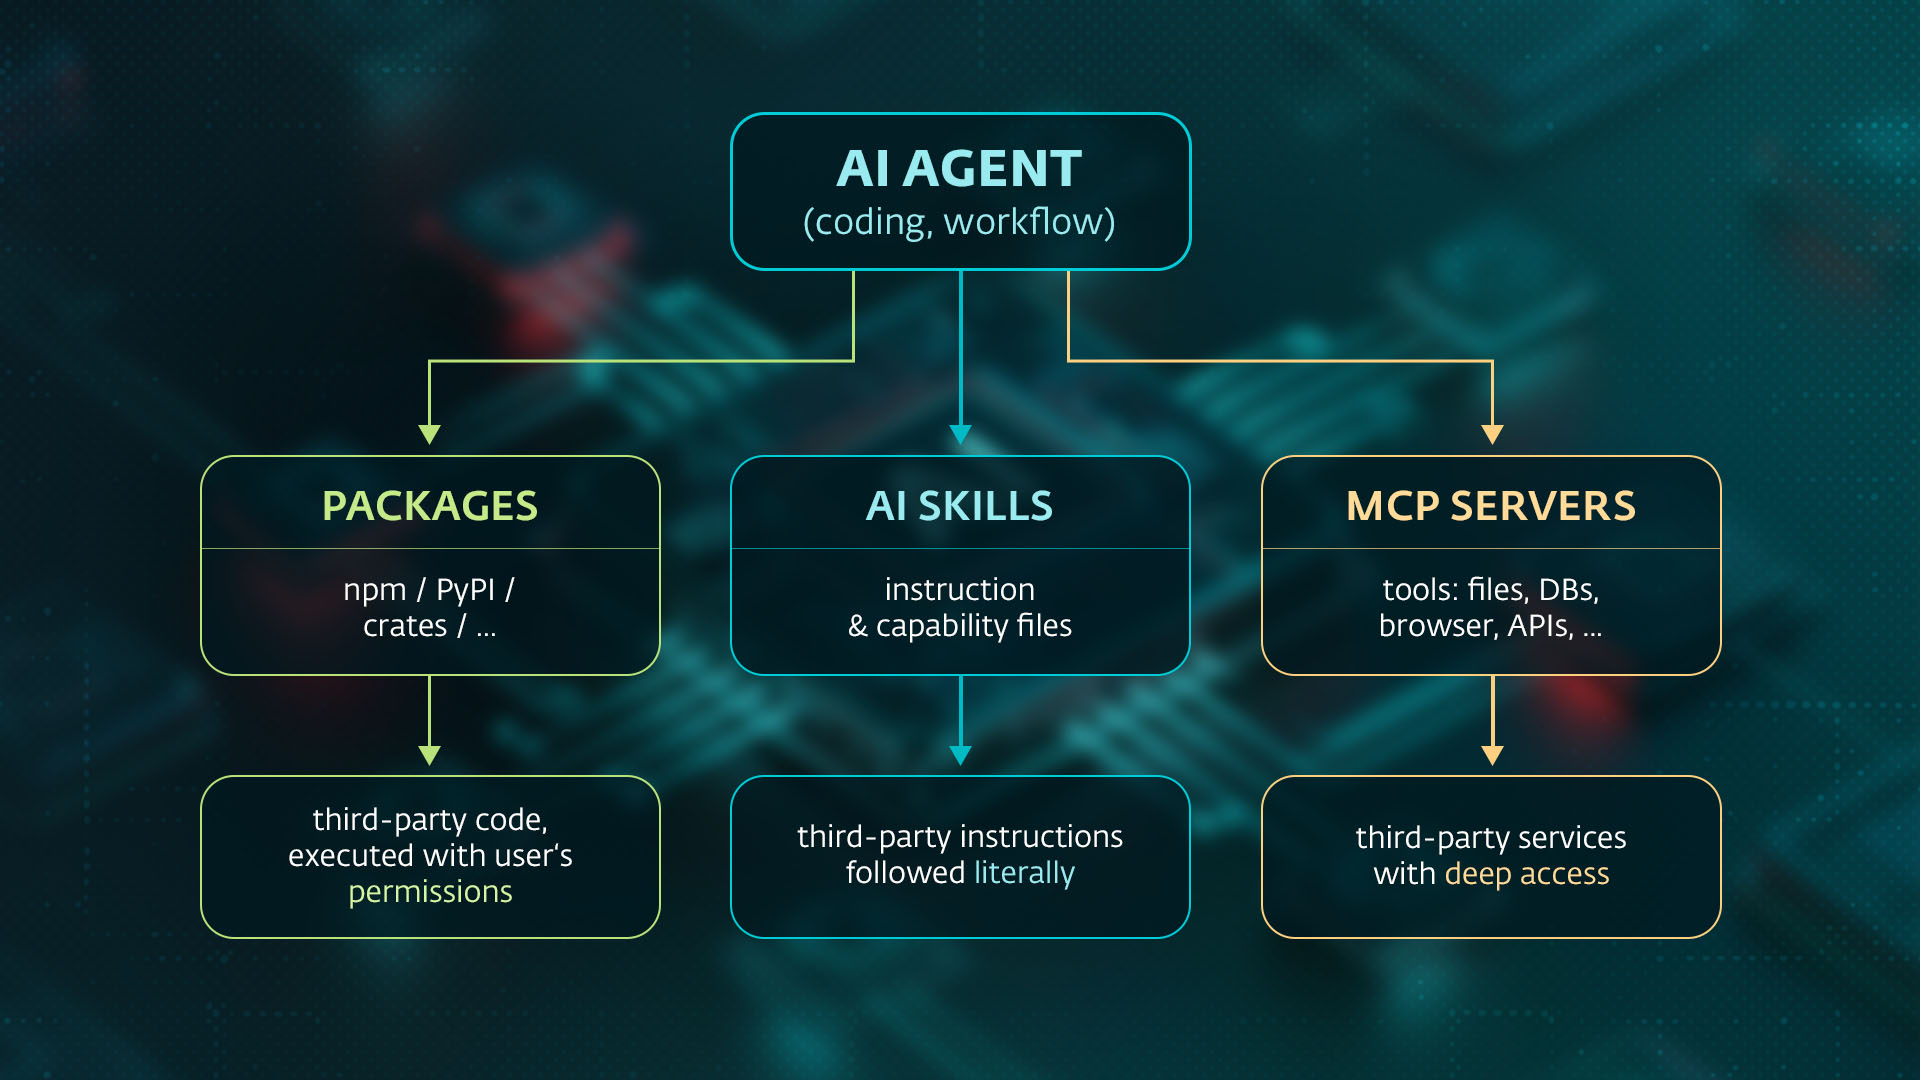
Inwiefern? KI-Agenten sind auf verschiedene externe Bausteine angewiesen, wie Softwarepakete (npm, PyPI, Crates), KI-Skills (wie oben beschrieben) und Model Context Protocol (MCP)-Server (Dienste, die Agenten Tools wie Dateizugriff, Datenbankabfragen oder Browsersteuerung bereitstellen).
Ja, auch npm-Pakete spielen hier eine wichtige Rolle. Betrachten wir nun die Auswirkungen.
Jedes einzelne davon ist ebenfalls von Code oder Anweisungen abhängig, die von Unbekannten im Internet geschrieben wurden. Und alle wurden bereits von Angreifern missbraucht durch:
- Typosquatting-Pakete, die wie beliebte Bibliotheken aussehen, aber Malware enthalten.
- Bösartige MCP-Server, die, sobald eine Verbindung hergestellt ist, alles lesen können, was der Agent liest, und Tool-Aufrufe auslösen können.
- Manipulierte Skill-Dateien und Datensätze, die versteckte Anweisungen enthalten, denen der Agent gehorsam folgt.
Entscheidend ist, dass Agenten diese Abhängigkeiten automatisch und mit Maschinen-Geschwindigkeit installieren, sodass ein Mensch niemals die Chance hat, sie zu überprüfen. Es handelt sich also um das klassische Problem der Software-Lieferkette, allerdings ohne die menschliche Kontrollinstanz. Die Frage ist also: Wo bleibt da die Sicherheitsüberwachung?
So ziemlich „im Dunkeln“.
Zurück in die Grauzone
Zuvor haben wir die „Blindzone“ oder Grauzone der Cybersicherheit im Zusammenhang mit potenziell unerwünschten und missbrauchten legitimen Fernüberwachungs-Apps erwähnt, die zu böswilligen Zwecken installiert wurden.
Dies ist hier erwähnenswert, da missbrauchte Komponenten der Software-Lieferkette technisch gesehen ebenfalls in diese Grauzone fallen können. Legitime und vertrauenswürdige Tools können zu kompromittierten Zugangspunkten werden, wie es bei SolarWinds Orion der Fall war. Vorherzusagen, welche Komponente als Nächstes missbraucht wird, ist kaum möglich, da diese Angriffe auf das implizite Vertrauen abzielen, das solche Tools innerhalb von Unternehmenssystemen bereits genießen.
Bevor wir jedoch das Kind mit dem Bade ausschütten, sollten wir bedenken, dass Vertrauen gesteuert werden kann und Angriffe nach wie vor erkannt werden können.
KI aus der Grauzone holen
Im Bereich der KI-Skills haben Unternehmen mehr Handlungsspielraum, als es auf den ersten Blick erscheinen mag. Das Problem ist nicht, dass Unternehmen mit neuen Tools experimentieren wollen. Das ist verständlich, insbesondere wenn Produktivitätssteigerungen und Wettbewerbsdruck Teil des Verkaufsarguments sind. Das Problem besteht darin, dieses Experimentieren als risikofrei zu betrachten.
In vielerlei Hinsicht mindert Bequemlichkeit die Sorgfalt. Wenn ein Skill, ein Connector oder ein Agent schnellen Nutzen verspricht, kann es verlockend sein, ihn erst einmal einzubinden und Sicherheitsfragen erst später zu stellen. Doch in einer KI-Lieferkette bringt jede hinzugefügte Funktion auch eine neue Abhängigkeit mit sich, sodass Prävention bereits beginnen muss, bevor diese Abhängigkeiten in den Arbeitsablauf gelangen dürfen.
Wie können wir also die KI aus dieser sogenannten Grauzone herausholen? Das ist relativ einfach. Betrachten Sie, wo der Einsatz von KI stattfindet: am Endpoint. Schließlich ist dies der Knotenpunkt ihrer Aktivitäten, an dem Mitarbeiter Daten suchen, hochladen und empfangen. Sie fragen sich vielleicht: „Aber sind die meisten Agenten nicht cloudbasiert?“ Das sind sie sicherlich. Dennoch senden und empfangen Sie weiterhin Daten zu und von Endpunkten – und genau dort findet die Interaktion mit der KI statt.
„KI ist eine neue Art von Akteur innerhalb des Unternehmens. Sie liest, schreibt, entscheidet und führt aus, im Idealfall mit menschlicher Genehmigung. Sie verdient dieselbe Aufmerksamkeit in Sachen Sicherheit wie Benutzer und Endgeräte, da sie sich wie beides zugleich verhält“, so Kamil Pšenák, Senior Product Manager bei ESET.
Das Problem bei der Absicherung des KI-Stacks
Die Sache ist die: „Der KI-Stack“ ist ein etwas vieldeutiger Begriff. Um ihn besser zu verstehen, lassen Sie uns die Nutzung von KI in Unternehmen in verschiedene Schichten unterteilen.
- Benutzer: Das sind die Menschen, die über Apps und Browser mit großen Sprachmodellen (LLMs) interagieren.
- KI-fähige Apps: Denken Sie beispielsweise an Ihre Textverarbeitungs-App mit integrierten KI-Funktionen zur Textbearbeitung.
- KI-Agenten: Mit anderen Worten: autonome Software, die zielgerichtet agiert, etwa beim Programmieren oder in Arbeitsabläufen, oder interne Geschäftsagenten.
- Agenten-Lieferkette: Wie oben beschrieben, handelt es sich hierbei um die verwendeten Pakete, Skills sowie MCP-Server oder Plug-ins.
- Laufzeitumgebung und Infrastruktur: Hier geschieht das Wunder: Endpunkte, dedizierte Maschinen, virtuelle Maschinen, Private Cloud, Plattformen zur Agentenerstellung (wie Prismatic oder n8n) usw.
- Modelle (LLMs): Dabei handelt es sich um Anwendungsprogrammierschnittstellen (APIs) in der öffentlichen Cloud sowie um gehostete oder lokal betriebene Modelle.
„Insgesamt kommt es darauf an, dass jede dieser Schichten mit den umliegenden kommuniziert. Jede einzelne von ihnen ist ein Kanal, über den Daten nach außen gelangen oder böswillige Anweisungen ausgelesen werden können. Mit anderen Worten: Alles, was den Kontext der KI erweitert, ist ein potenzieller Angriffsvektor“, sagte Filip Mazán, Leiter der AI Security Labs bei ESET.
Da die meisten KI-Ressourcen aus externen (von Drittanbietern gehosteten) Quellen stammen, konzentriert sich hier offensichtlich ein Großteil dieser Grauzone.
Aber zu behaupten, es handele sich ausschließlich um ein Problem der Cloud-Sicherheit, wäre eine große Ausrede. Man könnte meinen, dass es mehr Transparenz und Sicherheit hinsichtlich der verwendeten Agenten und Modelle gäbe, wenn LLM und Agenten auf internen Servern laufen würden. Das Hosting vor Ort löst jedoch nur ein Sicherheitsproblem: Ihre Eingabeaufforderungen werden nicht an einen Drittanbieter gesendet. Das ist großartig, insbesondere wenn Sie auf den Datenschutz bedacht sind.
Die folgenden Probleme bleiben jedoch weiterhin ungelöst:
- Ein lokal betriebenes Modell ist genauso anfällig für Prompt-Injection. Die Schwachstelle liegt in der Art und Weise, wie LLMs Text verarbeiten, nicht darin, wo sie gehostet werden.
- Ein Agent, der auf einem lokal betriebenen Modell basiert, kann weiterhin bösartige Befehle ausführen, manipulierte Pakete installieren und durch die von ihm gelesenen Inhalte manipuliert werden.
- Das Modell selbst ist Teil der Lieferkette: Open-Weight-Modelle werden aus öffentlichen Repositories heruntergeladen und können manipuliert oder mit Hintertüren versehen werden. „Man kann nicht wirklich wissen, was Teil der Trainingsdaten ist und was nicht“, sagte Mazán.
- Interne Datenlecks spielen nach wie vor eine Rolle. Eine interne KI mit Zugriff auf Personalunterlagen kann diese an einen Mitarbeiter weitergeben, der sie nicht einsehen darf.
- Man hat nach wie vor keinerlei Einblick darin, wer KI bzw. einen Agenten nutzt und wofür, es sei denn, man entwickelt das System selbst.
„Das Problem bei agentischer KI ist, dass eine Kompromittierung nicht mehr unbedingt wie Malware aussehen muss. Manchmal sieht es so aus, als würde ein vertrauenswürdiger Assistent genau das tun, was ihm gesagt wurde … nur dass es die falsche Anweisung war.“ Öffentliche LLMs, gehostete LLMs, On-Prem-LLMs: Es spielt keine Rolle, dass der Standort einige Risiken verändert, da es das Verhalten des Systems ist, das die meisten davon verursacht. Deshalb muss KI-Sicherheit den gesamten Stack umfassen, nicht nur das Modell“, sagte Pšenák.
Wussten Sie schon? Open-Weight-Modelle
Open-Weight-KI-Modelle sind Modelle, deren trainierte Parameter (Gewichte) anderen über Plattformen wie HuggingFace zum Herunterladen, Prüfen und Ausführen zur Verfügung gestellt werden. Ganz im Sinne von Open-Source-Software bieten Open-Weight-Modelle den Nutzern mehr Kontrolle und Transparenz, sind jedoch nicht immer vollständig Open Source: Die Trainingsdaten, der Code oder die Nutzungsbedingungen können weiterhin Einschränkungen unterliegen.
ESET äußert sich zur KI-Lieferkette
Ehrlich gesagt unterscheidet sich die Herausforderung der KI-Sicherheit nicht grundlegend von der traditionellen Lieferkettensicherheit, findet jedoch in größerem Maßstab statt. Die Anzahl und Vielfalt der Komponenten, die mittlerweile an der „Optimierung“ von Geschäftsprozessen beteiligt sind, hat zugenommen, was auch den erforderlichen Umfang der Maßnahmen zur Risikominderung erhöht hat.
ESET kann Unternehmen dabei helfen, agentenbasierte KI-Risiken auf zwei Ebenen zu reduzieren: erstens durch den Schutz der Bausteine, aus denen sich autonome Agenten selbst zusammensetzen, und zweitens durch die Überwachung ihrer Aktivitäten. Und so funktioniert es.
ESET KI-Agentensicherheit
Zunächst verfolgt ESET einen proaktiven Ansatz zur Verhinderung agentenbasierter böswilliger Aktivitäten. Das öffentliche Ökosystem, auf das Agenten zurückgreifen – wie verschiedene Softwarepakete, Skills und Server –, wird kontinuierlich überwacht, wodurch bösartige Artefakte erkannt werden, ohne dass diese jemals durch eine KI laufen müssen. Die Abwehr erfolgt auf zwei Endpunkt-Ebenen:
- URL-Ebene: Ein bösartiges Paket, eine Skill oder ein MCP-Server wird bereits beim Download blockiert, bevor es den Rechner erreicht.
- Dateiebene: Ist das Artefakt bereits vorhanden, wird es auf der Festplatte erkannt und blockiert, bevor ein Agent Zugriff darauf erhält.
Der entscheidende Punkt ist: bevor der KI-Agent Zugriff erhält. Folglich wird die manipulierte Abhängigkeit niemals Teil der Umgebung des Agenten. Auf diese Weise verkürzt sich die Reaktionszeit von tagelangen Scans auf eine einzige Abfrage. Doch dies allein reicht nicht aus, um die agentenbasierte Lieferkette zu sichern.
ESET KI-Verhaltensüberwachung
Die zweite Komponente einer umfassenden Sicherheit der agentenbasierten Lieferkette besteht darin, auch vor potenziell böswilligem Verhalten zu schützen. Autonome Agenten wie Programmierassistenten in VS Code, Claude Code, OpenClaw und ähnliche Tools führen echte Befehle auf echten Rechnern aus, weshalb ESET Behavioral Monitoring sie direkt am Endpunkt regelt durch:
- Sperrung: Ein Unternehmen kann entscheiden, dass diese Agenten schlichtweg nicht zugelassen sind; in diesem Fall werden sie erkannt und sofort blockiert.
- Überwachte Nutzung: Wo Agenten zugelassen sind, wird jede Aktion beobachtet. Wenn ein Agent versucht, einen Shell-Befehl auszuführen, wird der Inhalt vor der Ausführung auf böswillige Absichten überprüft. Ein eingeschleuster Agent, der versucht, ein Remote-Skript in eine Shell einzuspielen, Dateien zu exfiltrieren, Anmeldedaten zu manipulieren oder die Systemkonfiguration zu ändern, wird im Moment der Aktion gestoppt – unabhängig davon, wie er dazu manipuliert wurde, diese Handlungen auszuführen.
Dies ist Verhaltenssicherheit im klassischen Sinne für Endgeräte, angepasst an eine neue Art von Akteur. Der überwachte Prozess ist keine Malware, sondern ein legitimes KI-Tool, das aufgrund der von ihm erkannten Inhalte jederzeit gegen den Nutzer gerichtet werden kann. Die Verhaltensüberwachung geht davon aus, dass dies geschehen wird, und stellt sicher, dass es nicht dazu kommt.
Fazit: Die Kette unter die Lupe nehmen
Unternehmen setzen sich durch den Einsatz von KI einer breiteren Bedrohungslandschaft aus. Diejenigen, die diese Warnzeichen nicht erkennen, könnten überrascht sein, wenn ihr Agent sich ein wenig wie „Skynet“ verhält und unbeabsichtigtes Verhalten zeigt, wie zum Beispiel Datenexfiltration.
Deshalb muss der Einsatz von KI als Erweiterung der Lieferkette betrachtet werden und nicht nur als Software-Bereitstellung. Jedes neue Modell, jede neue Fähigkeit, jeder neue Konnektor und jedes neue Paket fügt ein weiteres vertrauenswürdiges Glied hinzu – und eine weitere Stelle, an der Kompromittierungen zunehmen können.
FAQ: Sicherheit der KI-Lieferkette
Was ist Sicherheit in der KI-Lieferkette?
Bei der Sicherheit der KI-Lieferkette geht es darum, alle externen Komponenten zu verstehen und zu schützen, auf die ein KI-System angewiesen ist – von Modellen und Skills bis hin zu Plug-ins, Paketen, Konnektoren und Datenquellen. Wie bei herkömmlicher Software besteht das Risiko, dass eine vertrauenswürdige Komponente unbemerkt zum Einfallstor für Angreifer wird, über das sie viele Systeme erreichen können.
Warum stellen KI-Agenten ein Sicherheitsrisiko dar?
KI-Agenten sind riskant, weil sie nicht nur Text generieren; sie können im Internet surfen, Daten abrufen, Tools aufrufen und darauf zugreifen sowie im Namen der Nutzer Aktionen ausführen. Das bedeutet, dass eine fehlerhafte Anweisung, eine bösartige Funktion oder eine manipulierte externe Quelle einen hilfreichen Assistenten zu einem aktiven Teil eines Angriffs machen kann.
Was ist eine Prompt-Injektion in der KI-Sicherheit?
„Prompt Injection“ ist ein Angriff, bei dem böswillige Anweisungen in Texten versteckt werden, die das KI-System liest, beispielsweise auf einer Webseite, in einem Dokument, in einer E-Mail oder in der Ausgabe eines Tools. Die Gefahr steigt, wenn es sich bei diesem KI-System um einen Agenten handelt, der die Berechtigung hat, auf Dateien zuzugreifen, Befehle auszuführen oder Daten zu verschieben.
Sind Open-Weight-KI-Modelle dasselbe wie Open-Source-Modelle?
Nicht immer. Bei Open-Weight-Modellen stehen die trainierten Parameter zum Herunterladen, Überprüfen und Ausführen zur Verfügung, was vom Grundgedanken her der Open-Source-Software ähnelt. Die Trainingsdaten, der Quellcode, die Sicherheitsmaßnahmen oder die Lizenzbedingungen können jedoch weiterhin Einschränkungen unterliegen.
Wie können Unternehmen Sicherheitsrisiken durch KI-Agenten reduzieren?
Unternehmen können Risiken mindern, indem sie regeln, welche KI-Tools zulässig sind, die Abhängigkeiten der Agenten überprüfen, Berechtigungen einschränken und das Verhalten am Endpunkt überwachen. Das Ziel ist nicht, den Einsatz von KI zu unterbinden, sondern sicherzustellen, dass vertrauenswürdige Automatisierung nicht unbemerkt zu einer Sicherheitsbedrohung wird.
Weitere Literaturhinweise:
[1] Z. Cui, M. Demirer, S. Jaffe, L. Musolff, S. Peng & T. Salz. (2025). Die Auswirkungen generativer KI auf hochqualifizierte Arbeit: Erkenntnisse aus drei Feldversuchen mit Softwareentwicklern. SSRN. https://doi.org/10.2139/ssrn.4945566
[2] ESET SMB MDR-Studie 2026 mit einer Stichprobengröße von 2.500 KMU mit bis zu 250 Geräten aus den USA, Großbritannien, Deutschland, Italien und Japan.